6GB 그래픽카드 gpt-oss-20b 실측: 전문가만 CPU에 두니 19.5 tok/s
gpt-oss-20b는 파일만 12~13GB라 6GB 그래픽카드에는 다 들어가지 않습니다. 그런데 이 모델은 MoE(전문가 혼합) 구조라, 토큰 하나를 만들 때 전체 21B 중 3.6B만 계산합니다. 그래서 크기의 대부분을 차지하는 '전문가' 가중치는 일반 메모리(RAM)에 두고 나머지만 그래픽카드에 올리는 방법이 있습니다. llama.cpp의 --n-cpu-moe입니다. Ollama에는 전문가만 따로 떼어 두는 설정이 없고, 그래픽카드에 올릴 층 수(num_gpu)만 정할 수 있습니다.
GTX 1660 SUPER 6GB + RAM 32GB PC에서 Ollama 기본값, Ollama 층 수 조절, llama.cpp 전문가 분리를 같은 한국어 질문으로 비교했습니다. 결론부터 정리하면 이렇습니다.
- Ollama 기본값 그대로도 15.6~16.5 tok/s였습니다. 같은 PC에서 14B 모델(Qwen3 14B)은 층 수를 맞춰도 6.4~6.9 tok/s였으니(14B 글), 6GB로 큰 모델을 쓰고 싶다면 gpt-oss-20b가 2배 넘게 빠릅니다(14B는 지난달 Ollama 0.34.4로 잰 값).
- llama.cpp에서 앞 14개 층의 전문가만 CPU에 두고(
--n-cpu-moe 14) 나머지를 모두 그래픽카드에 올리니 19.5 tok/s로, 같은 시간대 Ollama 기본(15.6)보다 1.25배 빨랐습니다. 대신 그래픽 메모리를 모델 몫만 약 5.6GB 써야 해서, 바탕화면·브라우저가 그래픽 메모리를 1GB쯤 쓰는 PC라면 18에서 시작해 16(이 PC에서 17.8 tok/s, 모델 몫 약 4.8GB)까지 내려 보는 편이 현실적입니다. - 같은 그래픽 메모리를 쓸 때 '전문가만 CPU'가 '층 통째로 나누기'보다 1.2~1.4배 빨랐습니다. 모델이 약 4.1GB를 차지할 때 18.7 대 13.3 tok/s(llama-bench), 약 5.6GB일 때 19.5 대 16.1 tok/s(실사용)였습니다.
- Ollama에서 층 수를 늘리면 오히려 느려졌습니다. 기본(CPU 71% / GPU 29%) 15.6 → 12층 12.7 → 14층 11.6 tok/s. 그래픽 메모리가 거의 꽉 찬 상태였습니다.
- 모든 전문가를 CPU에 둔 설정(
--n-cpu-moe 24)에서는 문맥을 4천·1만 6천 토큰 채워도 답 속도가 떨어지지 않았습니다. 같은 카드에서 8B를 그래픽카드에 다 올렸을 때는 8천 토큰에서 3분의 1 이하로 느려졌습니다. 그래픽 메모리를 거의 다 쓰는 설정(14)에서는 재 보지 않았습니다. - 긴 질문·문서를 넣는다면
-ub 2048을 더하세요. 2,048토큰 질문을 읽는 속도가 1.4~1.65배(--n-cpu-moe 14에서 143 → 204, 24에서 131 → 216 tok/s)로 빨라졌습니다. - Qwen3.6-35B-A3B(22GB)도 같은 방법으로 돌아갔습니다. 답은 초당 약 14~21토큰(설정별 평균 16~19)이었고, 질문 읽기는 기본 설정에서 짧은 질문일수록 매우 느렸지만(256토큰 질문 초당 22~38토큰)
-ub 2048로 2,048토큰 질문을 초당 약 198토큰에 읽었습니다. 측정 중 남은 RAM은 3.7~6.3GB까지 줄었습니다.
결과 1: 같은 질문으로 실제로 쓸 때
같은 한국어 질문에 256토큰을 쓰게 하고 3회 평균을 냈습니다(10-05 00:18~00:29, 같은 시간대). llama.cpp는 llama-server로, Ollama는 API로 불렀고 둘 다 생각 수준은 낮음(low)입니다.
| 방법과 설정 | 답 속도 (tok/s) | 그래픽 메모리 (모델 몫) |
|---|---|---|
llama.cpp --n-cpu-moe 14 |
19.5 (19.4~19.5) | 5.7GB (5.6GB) |
llama.cpp --n-cpu-moe 16 |
17.8 (17.7~18.0) | 4.9GB (4.8GB) |
llama.cpp -ngl 12 (층 나누기) |
16.1 (16.0~16.3) | 5.7GB (5.6GB) |
| Ollama 기본 (71%/29%) | 15.6 (15.4~15.7) | 4.2GB (4.0GB) |
llama.cpp --n-cpu-moe 24 |
12.7 (12.7~12.8) | 1.7GB (1.6GB) |
Ollama num_gpu 12 (53%/47%) |
12.7 (12.6~12.7) | 5.7GB (5.6GB) |
Ollama num_gpu 14 (46%/54%) |
11.6 (11.6~11.6) | 5.7GB (5.6GB) |
--n-cpu-moe N은 앞 N개 층의 전문가만 CPU에 두고 나머지는 모두 그래픽카드에 올리는 설정(24 = 모든 전문가 CPU),-ngl 12는 24층 중 12층만 그래픽카드에 올리는 설정입니다. Ollama 괄호는ollama ps에 나온 CPU/GPU 분담입니다.- 그래픽 메모리는
nvidia-smi로 본 전체 사용량(1GB = 1,024MiB)이고, 괄호는 측정 직전 사용량(약 0.12~0.13GB)을 뺀 모델 몫입니다. 카드 전체는 6GB(6,144MiB)입니다. 일반 메모리는 llama.cpp 기준 약 11GB를 더 썼습니다(남은 RAM 21.4 → 10.4GB). - 모든 전문가를 CPU에 두면(
--n-cpu-moe 24) 그래픽 메모리는 모델 몫 1.6GB만 쓰고도 12.7 tok/s가 나왔습니다. 그래픽카드가 4GB인 노트북에서도 시도해 볼 만한 숫자입니다(재 보지는 않았습니다). - Ollama 기본값은 이날 저녁(21:58)에도 한 번 쟀는데 16.5 tok/s였습니다. 같은 설정도 시간대에 따라 5% 안팎 달라서, 표의 비교는 같은 시간대에 잰 값끼리 했습니다.
결과 2: 그래픽 메모리를 얼마나 쓰면 얼마나 빨라지나
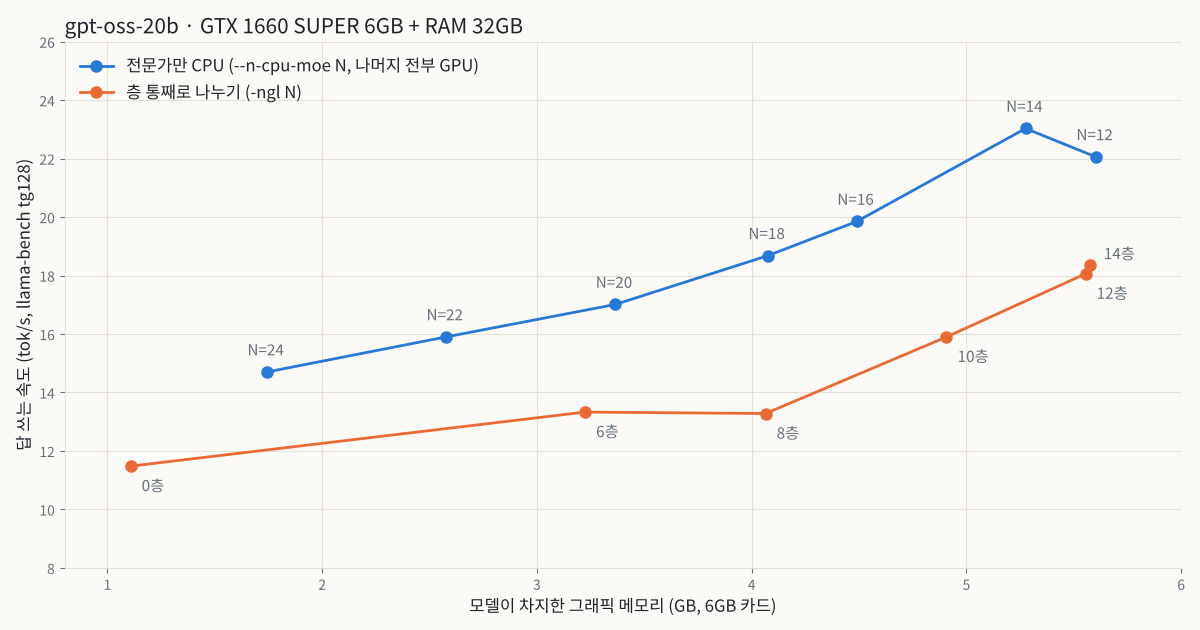
아래 표의 질문 읽기는 512토큰 기준, 모델 몫은 측정 중 최대 그래픽 메모리에서 측정 직전 사용량을 뺀 값입니다.
전문가 CPU 층 수 (-ncmoe) |
답 (tok/s) | 질문 읽기 (tok/s) | 모델 몫 |
|---|---|---|---|
| 24 (전부) | 14.7 | 121 | 1.7GB |
| 22 | 15.9 | 120 | 2.6GB |
| 20 | 17.0 | 123 | 3.4GB |
| 18 | 18.7 | 115 | 4.1GB |
| 16 | 19.9 | 128 | 4.5GB |
| 14 | 23.0 | 131 | 5.3GB |
| 12 | 22.1 | 104 | 5.6GB |
GPU 층 수 (-ngl) |
답 (tok/s) | 질문 읽기 (tok/s) | 모델 몫 |
|---|---|---|---|
| 0 (CPU만) | 11.5 | 120 | 1.1GB |
| 6 | 13.3 | 131 | 3.2GB |
| 8 | 13.3 | 124 | 4.1GB |
| 10 | 15.9 | 128 | 4.9GB |
| 12 | 18.1 | 127 | 5.6GB |
| 14 | 18.4 | 100 | 5.6GB |
- 12(전문가 분리)와 14층(층 나누기)에서는 질문 읽기가 100~104 tok/s로 떨어졌고, 답 속도도 더 오르지 않았습니다. 원인은 확인하지 못했지만, 6GB 카드에서는 이 근처가 한계로 보입니다.
- llama-bench 숫자는 실사용(결과 1)보다 높게 나왔습니다(
-ncmoe 1423.0 대 19.5). 문맥 크기(512 대 4,096), 측정 도구(llama-bench 대 llama-server), 시간대가 다르고 llama-bench의 첫 반복이 평균을 끌어올리는 점(아래)도 있으니, 결과 2는 설정끼리의 순서만 보세요. - 측정 도중 바탕 그래픽 메모리 사용량이 약 1.0GB에서 0.1GB로 줄었습니다(
-ncmoe 14측정 무렵, 다른 프로그램이 쓰던 그래픽 메모리를 Windows가 비운 것으로 보임). 그래서 그래프는 '모델이 차지한 몫'(측정 중 최대 − 측정 직전)으로 그렸습니다.
왜 전문가만 CPU에 두면 빠른가
gpt-oss-20b는 층이 24개이고, 층마다 '전문가'라는 작은 신경망이 32개씩 있습니다. 토큰 하나를 만들 때는 층마다 그중 4개만 씁니다. 그래서 전체는 21B인데 토큰마다 실제로 계산하는 몫은 3.6B입니다(모델 설명, 설정 파일).
- 층 통째로 나누기(llama.cpp의
-ngl. Ollama의num_gpu도 그래픽카드에 올릴 층 수를 정하는 설정): 일부 층은 전부 그래픽카드, 나머지 층은 전부 CPU가 맡습니다(llama.cpp는 뒤쪽 층부터 그래픽카드에 올림). CPU로 간 층은 어텐션(문맥을 읽는 부분)까지 CPU가 계산합니다. - 전문가만 CPU(
--n-cpu-moe): 모든 층의 어텐션과 공용 부분은 그래픽카드가 맡고, 크기의 대부분을 차지하는 전문가 가중치만 RAM에 둡니다. 토큰마다 RAM에서 읽는 것은 쓰이는 전문가 4개뿐입니다.
같은 그래픽 메모리를 써도 전문가 분리 쪽이 빨랐던 것은 이 차이 때문으로 보입니다. Ollama에는 전문가만 따로 떼어 두는 설정이 없습니다. 비슷한 방향으로 '전문가 가중치는 RAM에 두고 계산은 그래픽카드가 하게 해 달라'는 기능 요청이 올라와 있는 정도입니다(ollama#17557, 아직 열려 있음).
긴 문맥, 스레드, 메모리 매핑
모든 전문가를 CPU에 둔 상태(-ncmoe 24)에서 하나씩만 바꿔 봤습니다.
| 바꾼 것 | 답 (tok/s) |
|---|---|
| 문맥 0 → 4,096 → 16,384토큰 | 13.4 → 16.1 → 15.9 |
| 스레드 6 / 10(기본) / 20 | 14.7 / 14.7 / 14.2 |
메모리 매핑 끄기 (-lm none) |
15.0 (기본 14.7) |
- 문맥은 답 64토큰·2회만 쟀고, 2회 사이 차이가 최대 2.2 tok/s로 커서 "떨어지지 않았다"까지만 말할 수 있습니다.
- 스레드 수는 차이가 없었습니다. CPU 코어보다 메모리 읽기 속도가 한계로 보입니다.
- 메모리 매핑을 꺼도 답 속도는 거의 같았습니다. 질문 읽기는 137로 기본(121)보다 높았지만, 같은 시간대에 잰 스레드 측정도 126~127이라 차이가 크다고 보기 어렵습니다.
- 긴 문맥에 강한 이유(추정): gpt-oss는 24층 중 절반이 최근 128토큰만 보는 층(sliding window)이라 문맥이 길어져도 문맥 저장 공간이 적게 늘어납니다(설정 파일의
sliding_window: 128). 같은 카드에서 Qwen3 8B는 문맥 8,192토큰에서 47 → 13 tok/s로 떨어졌습니다(긴 문서 넣기). 다만 이번 표는 64토큰·2회만, 그래픽 메모리가 넉넉한 설정(1만 6천 토큰 문맥까지 넣어도 모델 몫 약 2.1GB)에서만 잰 것이라 흔들림이 크고, 8B와는 조건이 달라 문맥 저장 방식만의 차이라고 단정할 수는 없습니다. - llama-bench는 3번 반복하면 첫 번째가 나머지 두 번보다 대개 2~3 tok/s 빠르게 나왔습니다(평균을 1~2 tok/s 끌어올림). 표의 값은 3회 평균입니다.
긴 질문을 빨리 읽게 하기: -ub 2048
llama.cpp는 질문을 정해진 크기의 묶음(기본 512토큰, -ub)으로 나눠 읽습니다. 묶음이 32토큰 이상이면 RAM에 둔 전문가 가중치를 묶음마다 그래픽카드로 복사해 계산하고(llama.cpp#18530, --no-op-offload로 끌 수 있음), 묶음을 키우면 한 번 복사한 가중치로 더 많은 토큰을 처리합니다. 2,048토큰 질문으로 묶음 크기만 바꿔 봤습니다(llama-bench, 2회 평균).
| 설정 | -ub 512 (기본) |
-ub 2048 |
|---|---|---|
-ncmoe 24 |
131 tok/s | 216 tok/s |
-ncmoe 14 |
143 tok/s | 204 tok/s |
- 2,048토큰 질문을 읽는 시간이 약 14~16초에서 약 10초로 줄었습니다. 두 번 잰 값의 차이는 1.7 tok/s 이내였습니다.
- 대신 그래픽 메모리를 더 씁니다.
-ncmoe 24에서는 모델 몫이 약 1.8GB → 3.0GB로 늘었고,-ncmoe 14에서는 모델 몫 약 5.6GB(전체 약 5.75GB)로 겨우 들어갔습니다. llama-server로 문맥을 4,096토큰 잡으면 llama-bench보다 0.3GB쯤 더 쓰니(결과 1·2 비교), 14에-ub 2048을 함께 쓰면 6GB를 넘을 수 있습니다. N을 한두 단계 올려서 시작하세요. - 묶음마다 가중치를 그래픽카드로 보내는 기능을 끄면(
--no-op-offload, 전문가 계산을 CPU가 함) gpt-oss는 512토큰 질문 읽기가 134 → 62 tok/s로 느려졌습니다. gpt-oss에서는 끄지 마세요.
35B도 될까: Qwen3.6-35B-A3B
같은 방법으로 Qwen3.6-35B-A3B(총 35B, 토큰마다 약 3B 사용, 40층, 층마다 전문가 256개 중 8개 + 공유 전문가 1개 사용)의 Q4_K_M 파일(22.1GB)을 돌려 봤습니다. RAM이 빠듯해서 llama.cpp로만, 답 64토큰·질문 읽기 256토큰을 2회씩만 쟀습니다(표는 1회 / 2회 값, 그래픽 메모리는 전체 사용량, 묶음 크기는 기본값).
-ncmoe |
답 (tok/s) | 질문 읽기 (tok/s) | 그래픽 메모리 | 남은 RAM 최저 |
|---|---|---|---|---|
| 40 (전부) | 14.2 / 18.1 | 21.9 / 34.9 | 2.4GB | 6.3GB |
| 36 | 16.8 / 20.8 | 28.5 / 38.0 | 4.3GB | 5.5GB |
| 32 | 14.6 / 16.5 | 25.5 / 32.0 | 5.8GB | 4.6GB |
- 답은 gpt-oss-20b와 비슷한 속도로 나왔지만, 256토큰 질문을 읽는 속도는 초당 22~38토큰으로 매우 느렸습니다. 질문이 길수록 나아져서, 512토큰에서는 67 tok/s로 gpt-oss(121~134)의 약 절반이었습니다. 256토큰 질문이면 답을 쓰기 시작할 때까지 7~12초쯤 걸리는 셈입니다.
- 원인은 묶음마다 전문가 가중치를 그래픽카드로 보내는 시간으로 보입니다(추정).
-ncmoe 40에서 묶음 하나를 읽는 데 256토큰일 때 7~12초, 512토큰일 때 7~9초, 2,048토큰일 때 10~11초가 들어, 토큰 수가 8배가 돼도 시간은 크게 늘지 않았습니다. 묶음을 키우니 빨라졌고, 2,048토큰 질문 읽기가-ub 51293 →-ub 2048198 tok/s(2.1배)였습니다. 512토큰 질문에서는 그 기능을 끄는 쪽(--no-op-offload)이 오히려 빨랐습니다(67 → 102 tok/s, 기본 설정 쪽은 2회 값이 58 / 76으로 흔들림). gpt-oss와 반대입니다. - 정리하면, 35B를 6GB에서 쓴다면 512토큰 질문에서는
--no-op-offload가 기본보다, 2,048토큰 질문에서는-ub 2048이-ub 512보다 빨랐습니다(둘을 함께 쓴 경우, 2,048토큰에서--no-op-offload, 그 밖의 길이는 재 보지 않음).-ub 2048은 그래픽 메모리를 약 1.6~1.9GB 더 썼습니다. - 2회만 잰 데다 두 번 사이 차이가 커서 참고용입니다. RAM 32GB가 사실상 최소이고, 다른 프로그램이 RAM을 많이 쓰고 있으면 돌리지 않는 편이 좋습니다(이번에도 처음 시도는 측정 전 확인 기준으로 정한 남은 RAM 23GB에 못 미쳐(21.5~21.8GB) 건너뛰었고, 기준을 20.5GB로 낮춰 다시 돌렸습니다.
-ub 2048측정 중에는 남은 RAM이 3.7GB까지 줄었습니다).
한국어 답 품질
지난 글들과 같은 한국어 과제 8개를 Ollama 기본 설정(생각 수준 low, temperature 0)으로 풀게 했습니다. 다른 모델 7개의 답과 함께 과제마다 섞고 이름을 가린 뒤, 서로 결과를 보지 않는 채점자 둘(Claude)이 따로 채점했습니다(64개 중 57개 같은 점수, 나머지는 1점 차이).
| 모델 | 평균 (5점 만점) | 답 하나 평균 시간 |
|---|---|---|
| gpt-oss-20b (생각 low) | 3.88 | 약 14.7초 |
| 참고: Qwen3 8B (생각 끔) | 3.75 | 약 3.5초 |
| 참고: Qwen3 14B, 24층 (생각 끔) | 3.06 | 약 24.5초 |
- 시간은 모델 불러오기를 뺀 값이고, gpt-oss는 생각 시간이 들어 있습니다.
- 잘한 것: 요약·번역·계산·코딩은 5점이었습니다. 번역은 두 채점자 모두 5점을 줬습니다(8개 모델 중 둘 다 5점을 준 것은 gpt-oss뿐).
- 틀린 것: 훈민정음을 "1443년에 반포"라고 적었고(1443년은 창제, 반포는 1446년), 맞춤법 과제에서는 '몇일'을 '몇 일'로 바꾸고(맞는 표기는 '며칠') '어의없는', '괜찮아 질'은 그대로 두었습니다. 이메일에는 메모에 없는 날짜("4월 10일(화)")를 지어 넣었습니다.
- 생각 수준 low에서도 답 앞에 짧은 생각(영어)을 먼저 씁니다. 맞춤법 과제에서는 생각이 길어져(약 1,000자) 그 과제 하나에 28초가 걸렸습니다.
- gpt-oss-20b는 같은 채점의 8개 모델 중 3위였습니다. Gemma 4 E4B(4.25)와 E2B(4.00)가 더 높았습니다. 그래픽카드에 다 올라가는 작은 모델 비교는 2026 소형 모델 실측에 따로 정리했습니다.
따라 하기
llama.cpp Windows CUDA 빌드와 ggml-org/gpt-oss-20b-GGUF의 gpt-oss-20b-MXFP4.gguf(12.1GB)를 받은 뒤, 명령 프롬프트에서:
llama-server -m gpt-oss-20b-MXFP4.gguf -ngl 99 --n-cpu-moe 16 -c 4096
- 브라우저로
http://localhost:8080(기본 포트)을 열면 대화 화면이 나오고, 같은 주소로 OpenAI 방식 API(/v1/chat/completions)도 됩니다. - N 고르는 법: 24(전부 CPU)에서 시작해 2씩 줄이며 작업 관리자나
nvidia-smi로 그래픽 메모리와 답 속도를 보세요. 전체 사용량이 5.8GB를 넘거나 속도가 오히려 떨어지면 한 단계 되돌립니다. 이 PC(바탕 사용량 약 0.1GB)에서는 14(전체 약 5.7GB)가 가장 빨랐습니다. 바탕화면이 그래픽 메모리를 1GB쯤 쓰고 있다면 16이 경계(모델 몫 4.8GB + 1GB)이니 18부터 보세요. - 긴 문서를 자주 넣는다면
-ub 2048 -b 2048을 더하세요. 질문 읽기가 1.4~1.65배 빨라지는 대신 그래픽 메모리를 더 쓰니, N은 한두 단계 올려서 시작하세요. -ngl 99는 "일단 모든 층을 그래픽카드에"라는 뜻이고,--n-cpu-moe 16이 그중 앞 16개 층의 전문가만 CPU로 빼냅니다(뒤 8개 층의 전문가는 그래픽카드에 남음). 전문가 분리를 쓸 때는-ngl을 줄이지 마세요.- Ollama를 계속 쓴다면
num_gpu는 손대지 않는 편이 나았습니다(늘리면 느려짐). - 생각 수준을 바꾸려면 요청에
"chat_template_kwargs": {"reasoning_effort": "low"}를 넣습니다(이 글은 low로 측정).
측정 환경과 방법
- CPU: Intel Core i9-10900K (10코어), RAM: 32GB (DDR4-3200 16GB×2), 그래픽카드: NVIDIA GeForce GTX 1660 SUPER 6GB (드라이버 591.86), Windows 11 Home
- llama.cpp CUDA 12.4 빌드 b11193, Ollama 0.35.1
- 모델: gpt-oss-20b (OpenAI, 2025-08 공개, Apache 2.0). llama.cpp는 ggml-org의 MXFP4 GGUF(12,109,566,624바이트, sha256 확인), Ollama는
gpt-oss:20b(내려받는 크기 약 13GB). Qwen3.6-35B-A3B는 unsloth의 UD-Q4_K_M GGUF(22,134,528,992바이트) - 실사용 비교(결과 1): 질문 "6GB 그래픽카드에서 양자화가 어떻게 대형 언어 모델을 실행할 수 있게 해 주는지 200단어 정도로 설명해 주세요.", 생성 256토큰, temperature 0, seed 1, 문맥 4,096, 생각 수준 low. 첫 실행 제외 3회 평균
- llama-bench(결과 2): 질문 읽기 512토큰·답 128토큰, 3회 반복(깊이 측정은 64토큰 2회), 플래시 어텐션 기본값(auto). 묶음 크기 측정은 10-05 01:13~01:21에 질문 읽기만 2회씩 따로 쟀습니다
- 모든 측정 전에 다른 프로그램이 Ollama 모델을 올려 두지 않았는지, 그래픽 메모리 1.3GB 이하·CPU 30초 평균 25% 이하·남은 RAM이 충분한지(gpt-oss 11~13GB, 35B 20.5GB 이상) 확인했습니다. 이날 PC에는 다른 프로그램이 함께 켜져 있었습니다(확인 통과 시점 CPU 6~12%, 남은 RAM 약 21~23GB).
한계
- 그래픽카드 한 종류(GTX 1660 SUPER, 텐서 코어 없음)와 DDR4-3200 RAM(16GB×2)에서만 쟀습니다. 전문가를 RAM에서 읽는 방식이라 RAM 속도에 따라 결과가 크게 달라질 수 있습니다(DDR5라면 더 빠를 가능성이 큼).
- 실사용 비교는 짧은 질문 하나로 쟀습니다. 긴 질문 읽기는 llama-bench로 2,048토큰·2회만 쟀고, 실제 문서를 넣어 답까지 받아 보지는 않았습니다.
- 품질은 과제 8개로만 봤고, 채점자는 사람이 아니라 Claude 둘입니다.
- 측정 중 PC에서 다른 프로그램이 RAM을 약 9~10GB 쓰고 있었습니다. RAM을 더 비우면 35B 결과는 달라질 수 있습니다.