로컬 LLM 한국어 JSON 추출 6GB 실측: 형식은 format이, 날짜는 코드가
로컬 LLM으로 문자·주문·리뷰·문의 글에서 정보를 뽑아 JSON으로 받으면, 그 결과를 바로 프로그램에 넣을 수 있습니다. 그런데 모델이 가끔 설명을 붙이거나 마크다운 코드 블록 표시(백틱 세 개)로 감싸서 보내면 프로그램이 읽지 못합니다. Ollama에는 이걸 막는 format 옵션이 있습니다. 이 옵션이 형식만 지켜 주는지, 답의 정확도까지 바꾸는지 GTX 1660 SUPER 6GB에서 재 봤습니다.
지어낸 한국어 글 24개(약속 문자·주문·상품 리뷰·고객 문의 각 6개)에서 정해진 칸을 뽑게 하고, 같은 질문을 세 가지 방법으로 보냈습니다. ① 질문에 "JSON으로만 답하라"고만 쓰기 ② format: "json" ③ format에 JSON 스키마(칸 이름과 자료형)를 넣기. 모델은 6GB에 전부 올라가는 Qwen3 4B-instruct, Gemma 3 4B, Qwen3 8B(num_gpu 99, 생각 끄기)입니다.
결론부터 정리하면 이렇습니다.
- 질문만으로는 Gemma 3 4B가 24개 모두 코드 블록으로 감싸서 답했습니다. 그대로
json.loads에 넣으면 24개 전부 오류입니다. Qwen3 8B도 모델 기본 설정에서는 24개 중 5개를 감쌌습니다.format: "json"이나 스키마를 쓰면 세 모델 모두 24개 전부 바로 읽을 수 있는 JSON이었습니다. - 정확도는
format을 써도 그대로였습니다. 90칸 중 맞힌 칸이 Gemma 3 4B 86칸, Qwen3 4B-instruct 85칸, Qwen3 8B 86칸으로, 세 방법에서 틀린 곳까지 똑같았습니다. 이번 24개에서format은 형식만 지켜 주고 답의 내용은 바꾸지 않았습니다. - 느려지지도 않았습니다. 답 하나에 평균 Qwen3 4B-instruct 약 0.74초, Gemma 3 4B 약 1.22초, Qwen3 8B 약 1.35초였고, 방법에 따른 답 쓰는 속도 차이는 2% 안이었습니다.
- 가장 많이 틀린 곳은 "모레", "다음 주 월요일" 같은 상대 날짜였습니다. 오늘이 9월 29일 화요일이라고 알려 줘도 "모레"를 세 모델 모두 틀렸습니다(9월 29일 또는 30일로 답함). 주문 수량·단가·합계는 "2만 3천원", "세 개" 같은 표현까지 세 모델 모두 전부 맞혔습니다.
- 날짜는 모델에게 계산시키지 말고, 적힌 표현만 옮겨 적게 한 뒤 코드로 바꾸는 방법이 가장 확실했습니다. "모레", "다음 주 월요일"을 그대로 옮기게 하고 짧은 Python 함수로 날짜를 계산하니, 이번 약속 글 6개(그중 상대 날짜 2개)에서 세 모델 모두 6개 중 6개를 맞혔습니다. 질문에 2주 치 달력을 붙이거나 생각 모드를 켜도 "모레"는 여전히 틀렸고(Qwen3 8B는 맞히던 "다음 주 월요일"까지 틀림), 생각 모드는 답이 7배(8B) 넘게 느려졌습니다.
방법별로 바로 읽을 수 있는 JSON이 나온 비율
답을 아무 손질 없이 Python json.loads에 넣었을 때 읽힌 개수입니다(24개 중).
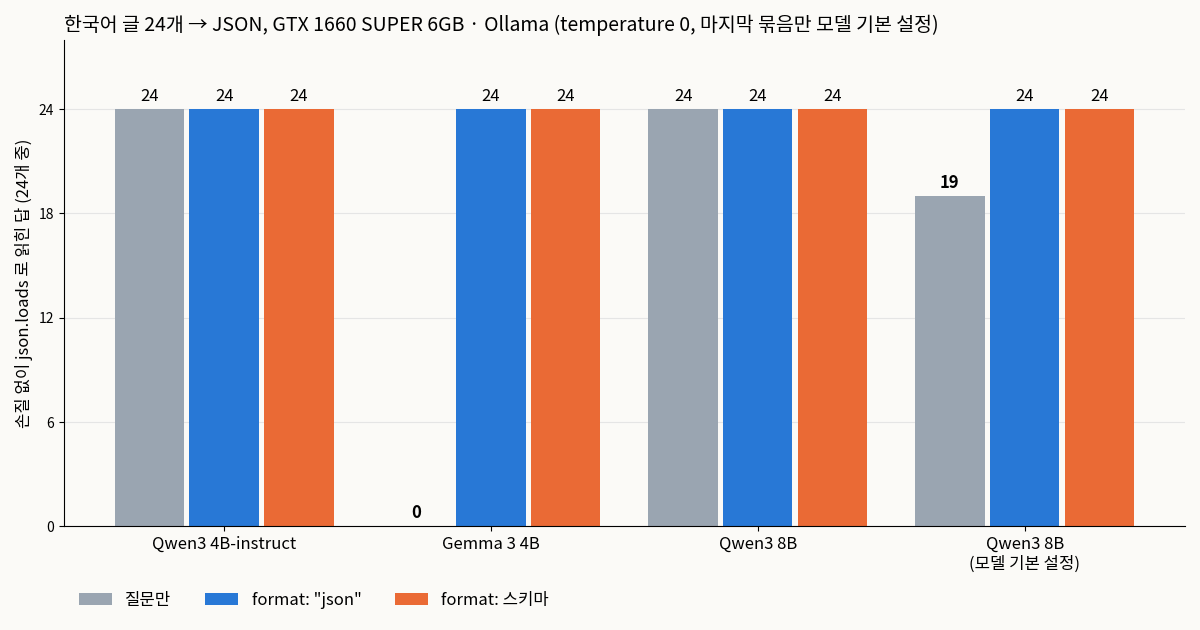
| 모델 | 질문만 | format: "json" |
format: 스키마 |
|---|---|---|---|
| Qwen3 4B-instruct | 24 / 24 | 24 / 24 | 24 / 24 |
| Gemma 3 4B | 0 / 24 (24개 모두 코드 블록) | 24 / 24 | 24 / 24 |
| Qwen3 8B | 24 / 24 | 24 / 24 | 24 / 24 |
| Qwen3 8B (모델 기본 설정) | 19 / 24 (주문 글 5개를 코드 블록으로) | 24 / 24 | 24 / 24 |
위 세 줄은 temperature 0입니다. 모델 기본 설정(temperature 등을 보내지 않고 모델에 들어 있는 값을 그대로 쓰는 경우, seed 1)으로도 한 번씩 돌렸는데, Qwen3 4B-instruct와 Gemma 3 4B는 결과가 위와 같았고 Qwen3 8B만 달라서 따로 적었습니다.
- 코드 블록을 벗겨 내면 모든 답이 읽혔고, 자료형도 전부 맞았습니다. 수량·금액은 숫자로, 참·거짓은
true/false로 왔습니다. 432개 답 중 숫자를 따옴표로 감싼 답은 없었습니다. - 즉 질문만 쓸 때 생긴 문제는 코드 블록으로 감싸는 것 하나였고, 감싼 개수는 모델과 설정에 따라 0개에서 24개까지 달랐습니다. 세 모델 모두
format을 켜면 이 문제가 생기지 않았습니다.
정확도: format을 바꿔도 틀린 곳이 그대로
글마다 정답을 정해 두고 칸별로 맞았는지 셌습니다(약속 4칸·주문 4칸·리뷰 3칸·문의 4칸, 모두 90칸). 장소·상품 이름은 핵심 단어가 들어 있으면 맞은 것으로 쳤습니다.
| 모델 | 맞힌 칸 (90칸) | 모든 칸을 맞힌 글 (24개) | 약속 | 주문 | 리뷰 | 문의 |
|---|---|---|---|---|---|---|
| Qwen3 4B-instruct | 85 | 19 | 22/24 | 24/24 | 18/18 | 21/24 |
| Gemma 3 4B | 86 | 20 | 22/24 | 24/24 | 17/18 | 23/24 |
| Qwen3 8B | 86 | 21 | 23/24 | 24/24 | 16/18 | 23/24 |
temperature 0 기준이고, 세 방법(질문만·json·스키마)에서 숫자가 모두 같았습니다. 모델 기본 설정에서도 Qwen3 4B-instruct와 Gemma 3 4B는 같았고, Qwen3 8B만 약속 한 칸을 더 틀리고 리뷰 한 칸을 덜 틀려서 맞힌 칸은 같은 86칸, 모든 칸을 맞힌 글은 20개였습니다.
틀린 곳은 이랬습니다.
| 글 (요지) | 정답 | Qwen3 4B-instruct | Gemma 3 4B | Qwen3 8B |
|---|---|---|---|---|
| "모레 정오에 … 면접 스터디" | 2026-10-01 | 09-30 ✗ | 09-29 ✗ | 09-30 ✗ |
| "다음 주 월요일 저녁 7시 반에 …" | 2026-10-05 | 10-04 ✗ (일요일) | 09-29 ✗ | 10-05 ✓ (기본 설정에서는 10-11 ✗) |
| "공일공 삼삼삼삼 칠칠칠칠로 연락 주세요" | 010-3333-7777 | 010-0000-0000 ✗ | 010-3337-7777 ✗ | 010-0000-0000 ✗ |
| "매장 영업시간이 궁금해요" (문의 종류) | 기타 | 배송문의 ✗ | ✓ | ✓ |
| "같은 주문이 두 번 결제됐어요 … 환불해 주세요" | 환불 | 교환 ✗ | ✓ | ✓ |
| "배송이 일주일이나 걸렸고 …" (배송 언급) | true | ✓ | false ✗ | ✓ |
| "처음엔 별로였는데 … 좋네요. 재구매 의사 있습니다. 택배는 평범하게 왔어요." | 긍정 / 배송 언급 true | ✓ | ✓ | 중립 ✗ / false ✗ (기본 설정에서는 긍정 ✓ / false ✗) |
- 상대 날짜가 가장 약했습니다. 질문에 오늘 날짜(2026년 9월 29일 화요일)를 적었는데도 "모레"를 셋 다 틀렸고, "다음 주 월요일"은 Qwen3 8B만 맞혔습니다. "10월 3일", "11월 12일"처럼 날짜가 적힌 글은 모두 맞혔습니다.
- Qwen은 모르는 전화번호를 질문의 형식 예시로 채웠습니다. 질문에 형식을
"010-0000-0000"으로 적어 두었는데, 한글로 읽어 쓴 번호를 숫자로 바꾸지 않고 그 예시를 그대로 답에 넣었습니다. 이번 스키마는 전화번호를 "문자열"로만 정해 두어 이런 값을 막지 못합니다. 스키마를 통과한 값도 코드에서 한 번 더 확인해야 합니다. - 주문 6개(상품·수량·한 개 가격·합계)는 세 모델 모두 24칸을 다 맞혔습니다. "2만 3천원"을 23000으로, "세 개"를 3으로 바꾸고, 합계가 적혀 있지 않은 글에서는 곱셈으로 채웠습니다.
상대 날짜 고치기: 달력 · 생각 모드 · 코드 계산
약속 글 6개를 세 가지 방법으로 다시 돌렸습니다(temperature 0, 스키마 사용). ②는 아래 '생각 모드' 절에서 24개 전체를 돌린 결과 중 약속 글 6개만 뽑은 것입니다. 표의 숫자는 날짜 칸 6개 중 맞힌 개수입니다.
| 방법 | Qwen3 4B-instruct | Gemma 3 4B | Qwen3 8B |
|---|---|---|---|
| 그대로 (위 결과) | 4 / 6 | 4 / 6 | 5 / 6 |
| ① 질문에 2주 치 달력 붙이기 | 5 / 6 | 4 / 6 | 4 / 6 |
| ② 생각 켜기 | 4 / 6 (생각 전용 qwen3:4b) |
(생각 기능 없음) | 4 / 6 |
| ③ 날짜 표현만 옮겨 적게 하고 코드로 계산 | 6 / 6 | 6 / 6 | 6 / 6 |
① 달력 붙이기: 오늘 날짜 문장 뒤에 9/29(화), 9/30(수), 10/1(목), … 10/12(월)을 붙였습니다. "모레"는 세 모델 모두 여전히 틀렸고, 오히려 Qwen3 8B는 맞히던 "다음 주 월요일"을 10-12로, Gemma 3 4B는 "모레"를 있지도 않은 2026-09-31로 답했습니다. 질문은 약 125토큰 길어졌습니다.
② 생각 켜기: 생각 내용(한글·영문 글자 중 93~95%가 영문)을 보면 틀린 이유가 드러납니다.
- 생각 전용 4B는 "'모레' means tomorrow, right?"라고 쓰고 9월 30일로 답했습니다. Qwen3 8B도 생각에서 "모레"를 "Tomorrow"로 옮겼습니다. 두 모델 모두 "모레"를 "내일"로 알고 있는 것입니다.
- Qwen3 8B는 질문에 "화요일"이라고 적혀 있는데도 생각 첫머리부터 "9월 29일은 수요일"로 옮겼고(약속 글 6개 중 5개), "다음 주 월요일"을 10월 5일이라고 했다가 수요일 기준으로 다시 세어 10월 4일로 바꿨습니다. 생각 없이 맞히던 문제를 생각을 켜고 틀린 것입니다.
- 대신 한글로 읽어 쓴 전화번호는 생각을 켜자 둘 다 010-3333-7777로 맞혔습니다.
③ 표현만 옮기고 코드로 계산: 질문과 스키마의 date 칸을 date_text("메시지에 적힌 날짜 표현을 바꾸지 말고 그대로", 예시 "다음 주 수요일"·"3월 2일")로 바꾸고, 오늘 날짜 문장은 뺐습니다. 세 모델 모두 6개 표현을 그대로 옮겼고("모레", "다음 주 월요일", "10월 15일(목)" 등, Qwen3 4B-instruct는 "모레 정오"처럼 시각까지 붙인 것 하나), 아래 함수로 바꾸니 18개 모두 맞았습니다. 시각·장소·인원 칸도 모두 맞았고, 답 길이는 약속 글 원래 답과 거의 같았습니다(약 50토큰).
import datetime as dt, re

WD = "월화수목금토일"
REL = {"오늘": 0, "내일모레": 2, "내일": 1, "모레": 2, "글피": 3}   # 긴 말부터 확인

def resolve(expr: str, today: dt.date):
    s = re.sub(r"\s+", "", expr)
    for word, days in REL.items():
        if s.startswith(word):
            return today + dt.timedelta(days=days)
    m = re.search(r"(\d{1,2})월(\d{1,2})일", s)
    if m:
        d = dt.date(today.year, int(m.group(1)), int(m.group(2)))
        return d if d >= today else d.replace(year=today.year + 1)
    m = re.search(r"(이번주|다음주|다다음주)(.)요일", s)
    if m and m.group(2) in WD:
        monday = today - dt.timedelta(days=today.weekday())      # 주는 월요일부터
        weeks = {"이번주": 0, "다음주": 1, "다다음주": 2}[m.group(1)]
        return monday + dt.timedelta(days=7 * weeks + WD.index(m.group(2)))
    return None          # 모르는 표현은 사람이 확인

today = dt.date(2026, 9, 29)
print(resolve("모레 정오", today), resolve("다음 주 월요일", today))   # 2026-10-01 2026-10-05
"다음 주"를 어느 요일부터 셀지는 서비스마다 정하기 나름이라, 이렇게 코드에 규칙을 적어 두는 쪽이 모델에게 맡기는 것보다 결과가 한결같습니다.
생각 모드를 켜면: 정확도는 비슷하고 훨씬 느리다
24개 전체를 생각을 켜고 다시 돌렸습니다(temperature 0, 생성 한도 3,500토큰).
| 모델 | 생각 | 맞힌 칸 (90칸) | 모든 칸을 맞힌 글 | 답 하나 평균 시간 (최대) |
|---|---|---|---|---|
| Qwen3 4B-instruct | 없음 | 85 | 19 | 0.74초 |
Qwen3 4B 생각 전용 (qwen3:4b) |
켜기 · 스키마 | 88 | 22 | 15.5초 (42.9초) |
| Qwen3 8B | 끄기 | 86 | 21 | 1.35초 |
| Qwen3 8B | 켜기 · 스키마 | 87 | 21 | 9.8초 (21.8초) |
| Qwen3 8B | 켜기 · 질문만 | 88 | 22 | 9.9초 (21.7초) |
- Qwen3 8B는 생각을 켜도 맞힌 칸이 1~2칸 늘었을 뿐입니다(전화번호 한 칸과 리뷰 두 칸을 더 맞혔지만, "다음 주 월요일"과 스키마 쪽은 재구매 한 칸을 새로 틀림). 이 정도 차이는 글 24개에서 우연으로도 생길 수 있습니다. 시간은 약 7.3배(1.35초 → 9.8초)로 늘었고, 늘어난 시간은 생각을 쓰는 시간입니다(답 하나에 평균 약 400토큰).
- 4B는 생각 전용
qwen3:4b(Thinking-2507)와 생각 없는qwen3:4b-instruct(Instruct-2507)가 서로 다른 모델이라, 3칸 차이와 약 21배(0.74초 → 15.5초, 생각 약 1,000토큰) 차이를 생각 모드만의 효과로 볼 수는 없습니다. - 상대 날짜 2개는 생각을 켠 세 경우 모두 틀렸습니다.
- 생각을 켠 채
format을 줘도 생각은 그대로 나왔습니다. Qwen3 8B의 생각 내용은 스키마를 줬을 때와 안 줬을 때 24개 모두 글자까지 같았고, 답도 공백 배치만 달랐습니다. 다만 답 하나("반품하고 다시는 안 삽니다"의 재구매 여부)는 스키마 쪽만true로 틀렸습니다. Qwen3 8B는 생각을 켜면 질문만 보내도 24개 모두 코드 블록 없이 읽혔습니다. - 짧은 추출 작업이라면 생각을 끄고 ③처럼 코드로 보완하는 편이 훨씬 빠릅니다. 생각 모드의 시간 부담은 생각 모드 글에 자세히 적었습니다.
속도와 메모리
| 모델 | 답 하나 평균 시간 | 답 쓰는 속도 | 답 길이 | 그래픽 메모리 최고 (6,144MiB 중) |
|---|---|---|---|---|
| Qwen3 4B-instruct | 0.74초 | 약 78 tok/s | 약 40토큰 | 3,441MiB |
| Gemma 3 4B | 1.22초 | 약 73 tok/s | 약 45토큰 | 4,043MiB |
Qwen3 8B (num_gpu 99) |
1.35초 | 약 46 tok/s | 약 41토큰 | 5,745MiB |
시간·속도·답 길이는 temperature 0에서 format: "json"과 스키마를 쓸 때의 값입니다. 그래픽 메모리는 두 번 돌린 것 중 최고값이고, 화면 표시에 쓰는 약 316MiB를 포함합니다. 질문만 보낸 경우도 답 쓰는 속도는 2% 안에서 같았고, Gemma 3 4B는 코드 블록 표시만큼 답이 5토큰 길어졌습니다. 모델마다 짧은 질문으로 한 번 불러온 뒤, 세 방법을 질문만 → json → 스키마 순서로 이어서 쟀습니다.
- 스키마로 형식을 강제해도 답 쓰는 속도가 떨어지지 않았습니다(예: Qwen3 8B 질문만 46.2, 스키마 45.9 tok/s).
- 질문만 보낸 방법은 평균 시간이 조금 길게 나왔는데(Qwen3 8B 1.50초 대 1.35초, Qwen3 4B-instruct 0.81초 대 0.74초), 글 종류가 바뀌는 첫 글 네 개에서 질문 읽는 시간이 더 걸렸기 때문입니다(8B 0.8~1.0초, 4B 약 0.5초씩). 이 방법을 맨 먼저 돌려서 생긴 차이로 보이며, 질문 읽는 시간과 답 쓰는 시간의 가운데값은 방법마다 같았습니다.
쓰는 법: format에 스키마 넣기
Ollama API 문서와 구조화 출력 안내 기준입니다. format에는 "json" 또는 JSON 스키마를 넣을 수 있고, 문서는 질문에도 JSON으로 답하라고 적으라고 권합니다. 이번 측정에서는 한 걸음 더 나가 질문에 칸 이름과 형식까지 적었습니다.
import json, requests

schema = {
    "type": "object",
    "properties": {
        "item": {"type": "string"},
        "qty": {"type": "integer"},
        "unit_price": {"type": "integer"},
        "total": {"type": "integer"},
    },
    "required": ["item", "qty", "unit_price", "total"],
}
prompt = ("아래 주문 메시지에서 주문 정보를 뽑아 JSON 객체 하나로만 답하세요.\n"
          "키와 형식:\n- item: 상품 이름 문자열\n- qty: 수량, 정수\n"
          "- unit_price: 한 개 가격(원), 정수\n- total: 총액(원), 정수\n"
          "설명이나 다른 글은 쓰지 마세요.\n\n"
          "메시지: 무선 마우스 2개 주문할게요. 개당 15,900원이죠?")
r = requests.post("http://localhost:11434/api/generate", json={
    "model": "qwen3:4b-instruct",
    "prompt": prompt,
    "format": schema,            # 또는 "json"
    "think": False,              # 생각 기능이 있다고 표시되는 모델이면 끄기
    "stream": False,
    "options": {"temperature": 0},
})
order = json.loads(r.json()["response"])
print(json.dumps(order, ensure_ascii=False))
# 이번 측정의 답: {"item": "무선 마우스", "qty": 2, "unit_price": 15900, "total": 31800}
- Ollama가 생각 기능이 있다고 표시하는 모델(이번에는
qwen3:8b와qwen3:4b-instruct)에는"think": false를 함께 보냈습니다. 생각을 켜면 답 전에 생각을 길게 씁니다 → 생각 모드 글 - 목록에서 고르는 칸(리뷰의 긍정·부정·중립, 문의 종류)은 스키마에
"enum": ["긍정", "부정", "중립"]처럼 넣었고, 세 모델 모두 목록 밖의 값을 쓴 적이 없었습니다. - 스키마는 모양만 보장합니다.
"010-0000-0000"같은 값, 실제와 다른 날짜(예: 모레 → 09-30), 합계가 수량×단가와 안 맞는 값은 코드에서 따로 확인하세요.
측정 환경과 방법
- CPU: Intel Core i9-10900K, RAM: 32GB (3200MHz)
- 그래픽카드: NVIDIA GeForce GTX 1660 SUPER 6GB, 드라이버 591.86, Windows 11 Home
- Ollama 0.34.4. 모델은 모두 Q4_K_M:
qwen3:4b-instruct,gemma3:4b,qwen3:8b를num_gpu 99로 등록한 사본("think": false). 생각 켜기 비교에는 생각 전용qwen3:4b(Thinking-2507)도 씀 - 글 24개: 약속 문자·주문·상품 리뷰·고객 문의 각 6개. 이름·전화번호·가게는 모두 지어낸 것입니다. 질문 앞부분에 뽑을 칸과 형식을 적었고, 약속 글에는 오늘 날짜(2026년 9월 29일 화요일)를 적었습니다
- 세 방법 모두 질문 글은 똑같고
format값만 다릅니다. temperature 0·seed 1, 그리고 모델 기본 설정(seed 1)으로 한 번씩. 문맥 길이 4,096, 생성 한도 400토큰(생각 켜기는 3,500토큰, 한도에 걸린 답은 없었음) - 모델마다 시작 전에 그래픽 메모리 1,200MB 이하·CPU 25% 이하가 될 때까지 기다렸고, 짧은 질문으로 모델을 먼저 불러온 뒤 쟀습니다. 기본 측정은 09-29 02:57~03:07, 후속(달력·날짜 표현·생각 켜기)은 03:22~03:40에 잼
- 채점은 정답표와 기계적으로 비교했습니다. 장소·상품 이름은 핵심 단어("달빛식당", "복사용지" 등)가 들어 있으면, 시·도는 "서울", "경기"처럼 이름이 들어 있으면 맞은 것으로 쳤습니다
한계
- 글 24개, 칸 90개입니다. 모델 사이의 1~2칸 차이는 우연일 수 있습니다. 모델 기본 설정은 seed 1로 한 번만 돌려서, Qwen3 8B의 "24개 중 5개 감쌈"도 한 번 잰 값입니다. 모델 순위보다 "format이 형식만 바꾸고 틀린 곳은 그대로"라는 점을 보세요.
- 모두 짧은 글(한두 문장)이었습니다. 긴 문서나 여러 건이 섞인 글, 칸이 많은 복잡한 스키마에서는 결과가 다를 수 있습니다.
- 세 방법을 늘 같은 순서(질문만 →
json→ 스키마)로 돌렸습니다. 시간 차이 해석에 이 순서가 섞여 있을 수 있습니다(위 '속도와 메모리' 참고). format은 Ollama가 답을 만드는 단계에서 형식을 강제하는 기능이라, 다른 실행 도구(llama.cpp 서버의 grammar 등)에서는 동작 방식이 다를 수 있습니다.- 그래픽카드 한 종류에서만 쟀습니다.