Qwen3 '생각 모드' 6GB 실측: 답은 4.7~5.6배 늦고 점수는 뚜렷이 오르지 않았다
Qwen3는 답하기 전에 속으로 "생각"을 길게 쓰는 기능(thinking)이 있습니다. 어려운 문제에서는 이게 정답률을 올린다고 알려져 있는데, 6GB 그래픽카드에서 평범한 한국어 일(이메일·요약·번역 등)을 시킬 때도 켤 만할까요? GTX 1660 SUPER 6GB에서 Qwen3 4B·8B·14B로 생각을 켜고 끈 채 같은 한국어 과제 8개를 풀게 하고, 걸린 시간과 답 품질(이름 가린 채점)을 비교했습니다. 설정은 두 가지로 쟀습니다. 매번 같은 답이 나오는 temperature 0, 그리고 Qwen이 권하는 설정(2회씩, 14B는 1회)입니다.
결론부터 정리하면 이렇습니다.
- 답 하나 기다리는 시간이 8B는 약 3.4초 → 16.0초(약 4.7배), 14B는 약 24초 → 132초(약 5.6배)로 늘었습니다. 생각까지 쓰느라 만들어야 할 토큰이 5~6배로 늘기 때문입니다. 그리고 그 생각은 한국어로 물어도 대부분 영어였습니다(8B·14B는 한글·영문 글자 중 94~95%가 영문).
- 답 품질은 뚜렷이 오르지 않았습니다. 이름을 가리고 두 채점자가 매긴 5점 만점 점수가 8B는 끄면 3.79점, 켜면 3.56점, 14B는 3.25점 → 3.50점이었습니다. Qwen 권장 설정만 보면 8B는 3.72점 대 3.69점으로 사실상 같았습니다. 사실 질문(세종시 출범·훈민정음 반포 연도)은 생각을 켠 답 가운데 둘 다 제대로 답한 것이 하나도 없었습니다.
- 4B는 태그부터 다릅니다. 지금
qwen3:4b는 생각 전용 모델이라think: false를 줘도 생각을 멈추지 않았습니다. 생각 없이 쓰려면 가장 간단한 방법은qwen3:4b-instruct를 받는 것입니다. 생각 전용 4B는 답 하나에 평균 37.7초가 걸렸고, 번역 과제는 세 번 모두 3,500토큰을 다 쓰고도 답을 내지 못했습니다(점수 2.85점, instruct는 3.65점). - 그래서 6GB에서 일상 한국어 작업이라면 생각을 끄고 쓰는 쪽을 권합니다. 계산처럼 단계가 필요한 문제도 이번 과제 수준에서는 생각 없이 거의 다 맞혔습니다.
걸린 시간
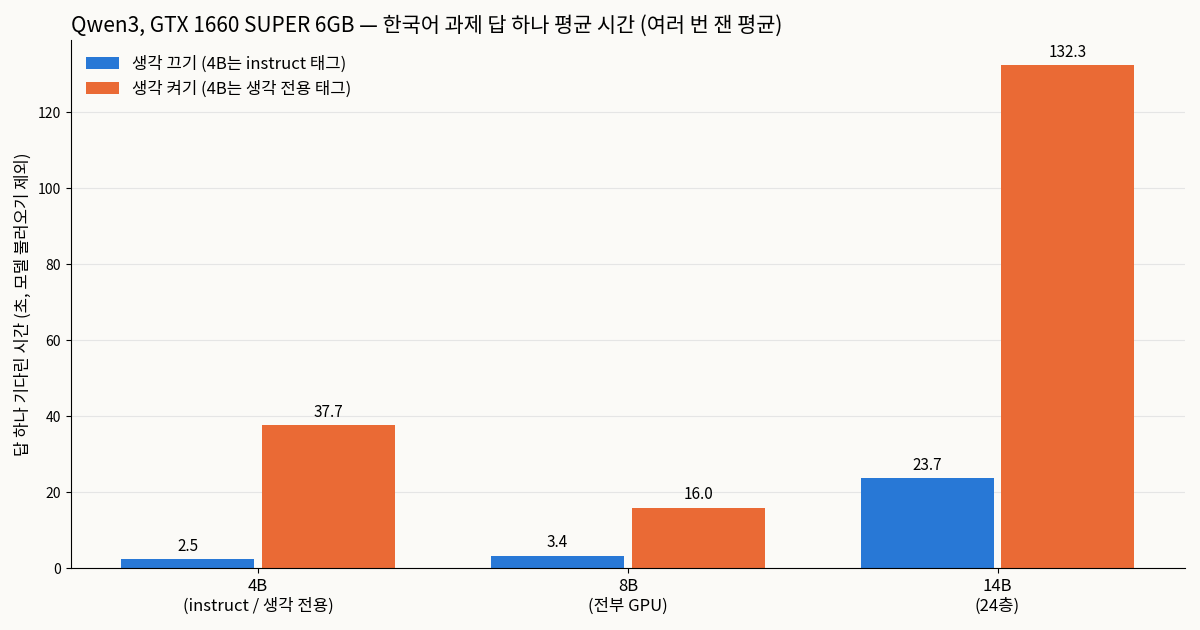
| 모델 (설정) | 생각 | 답 하나 평균 시간 (잰 횟수) | 생성 토큰 (과제당) | 그중 생각 (글자) | 답 쓰는 속도 |
|---|---|---|---|---|---|
| 4B-instruct (전부 GPU) | 없음 | 2.1~2.7초 (3회) | 157 | 0 | 73~78 tok/s |
4B 생각 전용 (qwen3:4b, 전부 GPU) |
항상 | 37.0~38.4초 (4회) | 2,396 | 7,526 | 62~71 tok/s |
8B (num_gpu 99, 전부 GPU) |
끄기 | 3.3~3.5초 (4회) | 116 | 0 | 43~46 tok/s |
8B (num_gpu 99, 전부 GPU) |
켜기 | 15.5~16.4초 (4회) | 654 | 1,801 | 42~44 tok/s |
14B (num_gpu 24) |
끄기 | 22.2~24.5초 (3회) | 125 | 0 | 5.4~6.7 tok/s |
14B (num_gpu 24) |
켜기 | 121~145초 (3회) | 688 | 1,891 | 3.6~6.1 tok/s |
잰 횟수에는 temperature 0 두 번(같은 설정을 한 번 더 돌린 것 포함, 4B-instruct는 한 번)과 권장 설정 한두 번이 섞여 있습니다. 토큰·글자 수는 그 평균입니다.
- 늘어난 시간은 거의 전부 생각을 쓰는 시간입니다. 답 쓰는 속도(tok/s)는 생각을 켜도 거의 그대로였고(8B 43~46 → 42~44), 써야 할 토큰이 5~6배로 늘었습니다.
- 14B는 과제 하나에 최대 3분 49초까지 걸렸습니다. 같은 설정을 다시 돌려도 평균이 121~145초로 20% 가까이 달랐는데, 14B를 켜 둔 동안 답 쓰는 속도가 3.6~6.1 tok/s로 들쭉날쭉했기 때문입니다. 원인은 따로 확인하지 못했습니다.
- temperature 0 설정을 한 번 더 돌렸을 때 답은 여섯 가지 설정 모두 글자 하나까지 같았고, 8B 시간 차이는 약 0.1초(1% 안)였습니다.
답 품질: 생각을 켜도 뚜렷이 나아지지 않았다
과제 8개(이메일 다듬기·요약·번역·사실 질문·계산·코딩·맞춤법·설명)의 최종 답만 모았습니다. 과제마다 16가지 답(모델·생각·설정 조합)의 순서를 섞고 이름과 설정을 가린 뒤, 서로 결과를 보지 않는 채점자 둘(Claude)이 1~5점을 매겨 평균냈습니다. 두 채점자 점수는 128개 중 107개가 같았고, 2개를 빼면 모두 1점 차이 안이었습니다.
설정별 평균 (5점 만점)
| 모델 | 생각 | temperature 0 | 권장 설정 1회차 | 권장 설정 2회차 | 평균 |
|---|---|---|---|---|---|
| 4B-instruct | 없음 | 3.75 | 3.62 | 3.56 | 3.65 |
| 4B 생각 전용 | 항상 | 2.75 | 2.75 | 3.06 | 2.85 |
| 8B | 끄기 | 3.94 | 3.81 | 3.62 | 3.79 |
| 8B | 켜기 | 3.31 | 3.62 | 3.75 | 3.56 |
| 14B | 끄기 | 3.12 | 3.38 | — | 3.25 |
| 14B | 켜기 | 3.50 | 3.50 | — | 3.50 |
과제별 평균 (위 설정들을 합친 값)
| 과제 | 4B-instruct | 4B 생각 전용 | 8B 끄기 | 8B 켜기 | 14B 끄기 | 14B 켜기 |
|---|---|---|---|---|---|---|
| 이메일 다듬기 | 3.2 | 2.3 | 3.8 | 3.5 | 3.5 | 4.0 |
| 요약 | 5.0 | 3.3 | 4.5 | 4.2 | 1.0 | 3.5 |
| 번역 | 3.5 | 1.0 | 4.3 | 4.3 | 5.0 | 3.5 |
| 사실 질문 | 3.0 | 2.3 | 2.0 | 1.3 | 1.0 | 1.0 |
| 계산 | 4.0 | 5.0 | 5.0 | 5.0 | 5.0 | 5.0 |
| 코딩 | 4.8 | 4.8 | 4.7 | 4.7 | 5.0 | 5.0 |
| 맞춤법 | 2.5 | 1.7 | 2.0 | 2.7 | 1.8 | 2.3 |
| 설명 | 3.2 | 2.3 | 4.0 | 2.8 | 3.8 | 3.8 |
- 8B는 temperature 0에서만 생각 모드가 뚜렷이 깎였습니다(3.94 → 3.31). 사실 질문은 세종시 출범을 1991년·훈민정음 반포를 1443년으로 더 틀렸습니다(끄면 2001년·1446년). 권장 설정에서는 켜고 끈 점수가 3.69 대 3.72로 같았습니다. Qwen이 "생각 모드에 temperature 0 같은 방식(greedy)을 쓰지 말라"고 한 경고와 맞아 보이지만, 14B·4B는 설정에 따른 차이가 없었고 8B의 차이도 같은 설정을 다시 돌렸을 때의 흔들림(0.2~0.3점)과 비슷한 크기입니다.
- 생각을 켠 8B는 이메일 끝에 설명을 붙이는 버릇이 있었습니다. "이메일은 정중하면서도 … 중점을 뒀습니다"처럼 본문 뒤에 해설을 덧붙인 경우가 설정과 관계없이 세 번 모두 나왔고, 생각을 끄면 한 번도 없었습니다(그래도 채점에서는 권장 설정 2회차가 4점).
- 14B는 요약만 확실히 나아졌습니다. 생각을 끄면 두 번 모두 요약 답에 한국어 단어 대신 러시아 문자가 섞인 단어("거ходят")가 나왔는데(14B 글에서도 본 문제), 켜면 사라졌습니다. 대신 번역은 점수가 내려갔습니다. 합치면 3.25 → 3.50점으로, 과제 8개로는 차이라고 하기 어렵습니다.
- 생각 전용 4B는 세 번 모두 가장 낮았습니다. 번역 과제는 세 번 다 생각만 3,500토큰을 쓰고 답을 내지 못했고, 한국어로 물었는데 영어로만 답한 경우가 두 번(요약·이메일), 설명에 한자("家里")가 섞인 경우가 한 번 있었습니다.
- 사실 질문은 모두 약했습니다. 두 연도(2012년·1446년)를 다 맞힌 답은 16개 중 4B-instruct 권장 설정 2회차 하나였습니다. 생각 전용 4B의 temperature 0 답은 숫자는 맞혔지만 1446년을 '반포'가 아니라 '창제'라고 썼습니다(창제는 1443년).
- 같은 설정도 돌릴 때마다 꽤 달랐습니다. 4B-instruct 권장 설정은 2회차에서 사실 질문을 맞힌 대신 계산 답 마지막 줄이 "160이나야 합니다"로 깨졌습니다(1회차는 1,600원). 과제 하나의 1~2점 차이는 우연일 수 있다는 뜻입니다.
4B는 태그를 골라야 한다
첫 측정 글에서 "4B 기본 태그는 한국어로 물어도 영어로 생각만 한다"고 적었는데, 이유가 분명해졌습니다. Ollama의 qwen3:4b는 태그 목록 기준으로 qwen3:4b-thinking-2507-q4_K_M과 같은 모델(ID 359d7dd4bcda)입니다. 생각 전용으로 나온 판이라, 이번에도 think: false를 보냈지만 답 자리에 영어 생각을 그대로 써 내려가다 700토큰에서 잘렸습니다(temperature 0·권장 설정 모두, 과제 8개 전부).
| 쓰고 싶은 것 | 받을 태그 |
|---|---|
| 생각 없이 바로 답하는 4B | qwen3:4b-instruct (= qwen3:4b-instruct-2507-q4_K_M) |
| 생각하는 4B | qwen3:4b (= qwen3:4b-thinking-2507-q4_K_M) |
| 켜고 끌 수 있는 모델 | qwen3:8b, qwen3:14b (이번에 한 모델에서 켜기·끄기 모두 동작 확인) |
태그 목록에는 문맥 길이가 40K로 적힌 qwen3:4b-q4_K_M도 따로 있습니다. 처음 나온 켜고 끄는 4B로 보이지만 이번에는 재지 않았습니다.
생각 켜고 끄는 법
Ollama 안내 기준입니다. 8B·14B처럼 켜고 끌 수 있는 모델에서 동작합니다.
- 명령 한 줄:
ollama run qwen3:8b --think=false(켜려면--think, 생각은 하되 화면에 안 보이게 하려면--hidethinking) - 대화 중:
/set nothink또는/set think - API:
/api/generate·/api/chat요청에"think": false. 켜면 생각은thinking칸에, 답은 따로 나옵니다.
curl http://localhost:11434/api/generate -d "{\"model\":\"qwen3:8b\",\"prompt\":\"hello\",\"stream\":false,\"think\":false}"
(Windows 명령 프롬프트(cmd)용입니다. PowerShell은 따옴표 처리 방식이 달라 이대로는 동작하지 않습니다.)
측정 환경과 방법
- CPU: Intel Core i9-10900K, RAM: 32GB (3200MHz)
- 그래픽카드: NVIDIA GeForce GTX 1660 SUPER 6GB, 드라이버 591.86, Windows 11 Home
- Ollama 0.34.4. 모델은 모두 Q4_K_M:
qwen3:4b-instruct,qwen3:4b(생각 전용),qwen3:8b를num_gpu 99로 등록한 사본,qwen3:14b(num_gpu 24, 14B 글에서 가장 빨랐던 값) - 과제: 이전 품질 비교와 같은 한국어 과제 8개. 문맥 길이 4,096, 생성 길이 한도는 생각 끄기 700토큰, 켜기 3,500토큰(생각 포함)
- 설정: ① temperature 0·seed 1 ② Qwen 권장값 — 생각 켜기 temperature 0.6·top_p 0.95·top_k 20, 끄기(와 4B-instruct) 0.7·0.8·20, min_p 0, seed 1과 2
- 시간은 Ollama가 돌려준 전체 시간에서 모델 불러오기 시간을 뺀 값입니다(질문 읽기 + 생각 + 답)
- 설정마다(과제 8개 묶음) 시작 전에 그래픽 메모리 1,200MB 이하·CPU 25% 이하가 될 때까지 기다렸습니다(최대 20분). temperature 0은 09-28 22:37~23:42(두 번, 4B-instruct만 09-29 02:17), 권장 설정은 09-29 00:55~02:18에 잼
한계
- 과제 8개입니다. 수학 경시 문제나 긴 추론처럼 생각이 도움이 된다고 알려진 문제는 넣지 않았습니다. 그런 문제에서는 결과가 다를 수 있습니다.
- 권장 설정은 무작위성이 있어 2회(14B는 1회)만으로는 흔들림이 큽니다. 위에서 본 것처럼 같은 설정도 회차마다 과제 점수가 3점까지 달라졌습니다.
- 채점자는 AI(Claude) 둘입니다. 사람 채점과는 다를 수 있고, 다른 글의 품질 점수와는 채점 대상과 기준이 달라 직접 비교할 수 없습니다.
- 그래픽카드 한 종류에서만 쟀습니다. 14B(Ollama 기준 약 10GB)가 전부 올라가는 12GB 이상 카드라면 훨씬 빨라서 생각 모드의 시간 부담이 작아집니다.