6GB 그래픽카드 Qwen3 14B: 층 수 조절로 1.5배, 그래도 8B의 6분의 1
6GB 그래픽카드에 14B 모델은 다 들어가지 않습니다. 그래서 Ollama는 모델의 일부를 CPU 쪽에 두는데, 얼마나 그래픽카드에 올릴지(num_gpu)를 직접 정하면 얼마나 빨라질까요? GTX 1660 SUPER 6GB에서 Qwen3 14B를 층 수만 바꿔 가며 두 번(순서대로 한 번, 거꾸로 한 번) 쟀습니다.
결론부터 정리하면 이렇습니다.
- Ollama 기본값은 4.2~4.3 tok/s, 24~26층을 올리면 6.4~6.9 tok/s로 약 1.5~1.6배 빨라졌습니다. 두 번 잰 결과가 모두 같은 방향이었습니다.
- 더 많이 올린다고 계속 빨라지지는 않았습니다. 28층에서는 두 번 모두 26층보다 느려졌습니다(6.0 · 5.7 tok/s).
- 그래도 8B보다 훨씬 느립니다. 같은 카드에서 8B는
num_gpu 99로 약 41 tok/s였습니다(첫 측정 글, 생성 길이 256토큰 기준이라 조건이 조금 다릅니다). 14B를 가장 빠르게 해도 6분의 1 수준입니다. - 답 품질도 8B보다 낫지 않았습니다. 같은 밤에 한국어 과제 8개를 두 모델에 풀게 하고 모델 이름을 가린 채 채점했더니, 5점 만점에 14B 3.38점, 8B 3.81점이었습니다. 과제 수가 적어 "14B가 더 못한다"고까지 말하기는 어렵지만, 느린 만큼 낫다는 근거는 나오지 않았습니다. 6GB라면 8B를 권합니다.
결과
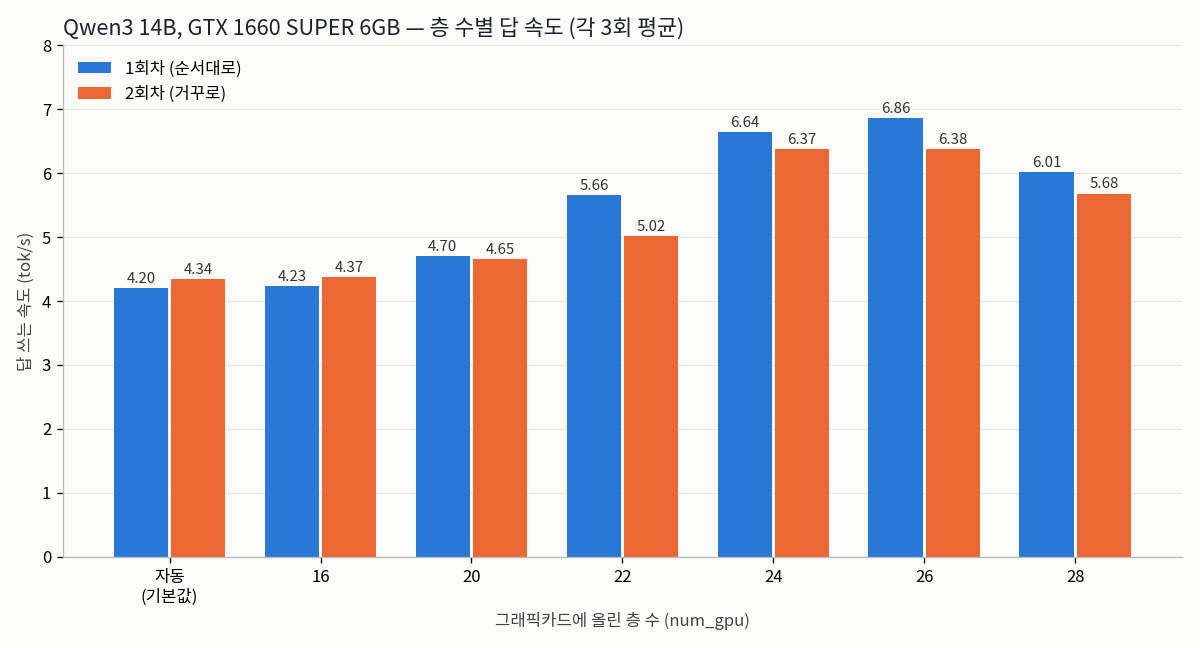
그래픽카드에 올린 층 (num_gpu) |
CPU / GPU 분담 (ollama ps) |
1회차 | 2회차 | 측정 중 그래픽 메모리 |
|---|---|---|---|---|
| 자동 (기본값) | 59% / 41% | 4.20 | 4.34 | 약 4.4~5.1GB |
| 16 | 59% / 41% | 4.23 | 4.37 | 약 4.4~5.1GB |
| 20 | 50% / 50% | 4.70 | 4.65 | 약 5.3~5.5GB |
| 22 | 46% / 54% | 5.66 | 5.02 | 약 5.7GB |
| 24 | 42% / 58% | 6.64 | 6.37 | 약 5.7GB |
| 26 | 37% / 63% | 6.86 | 6.38 | 약 5.7GB |
| 28 | 33% / 67% | 6.01 | 5.68 | 약 5.7GB |
단위는 tok/s(초당 토큰), 각 3회 평균입니다. 3회 안에서는 편차가 대부분 0.05 tok/s 안쪽이었습니다(1회차 22층 5.56~5.82, 24층 6.59~6.70 제외). 그래픽 메모리는 nvidia-smi로 본 전체 사용량이라, 바탕화면 등이 쓰는 몫이 들어 있습니다.
- 이번 조건에서는 기본값이 16층과 같은 배치로 보였습니다. 분담 비율(59% / 41%), 그래픽 메모리, 속도가 두 번 모두 같았습니다. 기본값은 Ollama가 남은 그래픽 메모리를 보고 정하므로 조건이 바뀌면 달라질 수 있습니다.
- 24층과 26층은 2회차에서 거의 같았습니다(6.37 · 6.38). 1회차에서는 26층이 조금 빨랐습니다. 둘 중 어느 쪽이든 좋습니다.
- 22층 이상은 2회차가 4~11% 낮았고, 20층 이하는 두 회차 차이가 ±3% 안이었습니다. 이 PC에서는 같은 설정도 잰 시각에 따라 10% 안팎 차이가 난 적이 있어서(첫 측정 글의 8B 기본값 14.4~16.3 tok/s), 층 수 사이의 비교는 같은 회차 안에서만 하세요.
한국어로 보면, 26층일 때 초당 약 10자(한글만 세면 약 7자)입니다. 128토큰짜리 짧은 답 하나에 약 20초가 걸립니다. 기본값이면 약 30초입니다.
28층에서 느려진 이유 (추정)
28층에서는 그래픽카드 몫이 더 늘었는데(67%) 오히려 느려졌습니다. 측정 중 그래픽 메모리는 22~28층 모두 약 5.7GB(6,144MB 중)로 거의 꽉 차 있었고, 모델이 차지한 몫(전체에서 측정 전 사용량을 뺀 값)도 22층부터는 층을 더 올려도 약 5.2~5.3GB에서 거의 늘지 않았습니다. Windows는 그래픽 메모리가 모자라면 일반 메모리를 빌려 쓰는 "공유 GPU 메모리"를 쓰는데, 일부가 그쪽으로 갔을 수 있고 28층에서 그 몫이 커져 느려졌을 가능성이 있습니다. 다만 공유 메모리 사용량을 따로 재지 않아서 확인하지 못했습니다. 확실한 것은 "많이 올릴수록 빠르다"가 26층 근처에서 끝난다는 점입니다.
두 번 잰 이유
1회차 도중 측정 조건이 하나 바뀌었습니다. 측정 전 그래픽 메모리(모델을 내린 상태에서 쓰는 양)가 20층까지는 1,031MB였는데, 22층 측정 전에는 637MB, 24층부터는 약 380~400MB로 줄었습니다. 무엇이 메모리를 풀었는지는 확인하지 못했습니다. 그러면 22층 이상이 빨라진 게 층 수 때문인지, 여유 메모리가 늘어서인지 가를 수 없습니다.
그래서 곧바로 순서를 거꾸로(28층부터) 한 번 더 쟀습니다. 2회차는 처음부터 끝까지 측정 전 메모리가 359~445MB로 비슷했습니다. 그런데도 자동·16층·20층은 1회차와 거의 같은 4.3~4.7 tok/s가 나왔고, 24~26층이 가장 빠르다는 결과도 같았습니다. 층 수에 따른 차이가 메모리 여유 변화만으로 생긴 것은 아니라고 봅니다. 다만 여유 메모리 자체도 중요합니다. 22층 이상에서는 모델이 약 5.2~5.3GB를 차지하므로, 다른 프로그램이 1GB쯤 쓰고 있으면 6GB 안에 다 들어가지 않습니다.
참고로 전날 다른 작업이 돌던 중에 잰 첫 측정은 기본값이 3.1 tok/s(2회 평균)로 훨씬 낮게 나왔습니다(측정 전 그래픽 메모리 약 2GB). 이번 두 회차는 새벽 시간에, 측정 스크립트가 그래픽 메모리와 CPU 사용량이 낮은지 먼저 확인한 뒤 돌렸습니다.
답 품질: 느린 만큼 낫지는 않았다
속도 측정이 끝난 뒤, 같은 새벽에 두 모델로 한국어 과제 8개(이메일 다듬기·요약·번역·사실 질문·계산·코딩·맞춤법·설명)를 풀게 했습니다. 14B는 24층을 올렸고, 8B는 num_gpu 99로 전부 그래픽카드에 올렸습니다. 답은 과제마다 A·B 순서를 무작위로 섞고 모델 이름을 가린 뒤, 서로 결과를 보지 않는 채점자 둘(Claude)이 따로 1~5점을 매겼고 두 점수를 평균냈습니다.
| 과제 | 14B (24층) | 8B |
|---|---|---|
| 이메일 다듬기 | 3.0 | 4.0 |
| 요약 | 3.0 | 5.0 |
| 번역 | 4.0 | 5.0 |
| 사실 질문 | 1.0 | 2.0 |
| 계산 | 5.0 | 5.0 |
| 코딩 | 5.0 | 4.5 |
| 맞춤법 | 2.0 | 1.5 |
| 설명 | 4.0 | 3.5 |
| 평균 | 3.38 | 3.81 |
- 14B가 깎인 곳: 요약 답에 한국어 단어 대신 러시아 문자가 섞인 단어("거ходят")가 나왔고, 이메일에서는 메모의 "다음주 화요일"을 "이번 주 화요일"로 바꿔 썼습니다. 사실 질문(세종시 출범 연도, 훈민정음 반포 연도)은 둘 다 틀렸습니다(2013년·1443년, 정답은 2012년·1446년).
- 8B도 완벽하지 않았습니다. 사실 질문에서 세종시 연도를 틀렸고(2001년), 맞춤법 과제에서는 "안 나왔어요"의 "안"을 빠뜨려 뜻을 뒤집었습니다. "몇일"을 "며칠"로 고치지 못한 것은 두 모델이 같았습니다.
- 과제 8개, 한 번씩만 풀린 결과라 차이가 우연일 수 있습니다. 다만 "14B가 더 똑똑하니 느려도 쓸 만하다"는 기대를 뒷받침하는 결과는 아니었습니다.
- 이 채점은 이 글 안에서만 비교하세요. 다른 글의 품질 점수는 채점 대상과 기준이 달라 직접 비교할 수 없습니다.
과제를 푸는 동안의 답 속도는 14B가 4.9~6.1 tok/s, 8B가 44~46 tok/s였습니다. 과제 답이 짧은 질문 측정보다 길어서(최대 약 300토큰) 14B는 위 속도 표보다 조금 느렸습니다.
따라 하기
Ollama API로 한 번 물을 때 num_gpu를 넣으면 됩니다. 아래는 Windows 명령 프롬프트(cmd)용입니다(PowerShell에서는 curl 대신 curl.exe).
curl http://localhost:11434/api/generate -d "{\"model\":\"qwen3:14b\",\"prompt\":\"hello\",\"stream\":false,\"think\":false,\"options\":{\"num_gpu\":24}}"
늘 이 값으로 쓰려면 Modelfile을 만들어 새 이름으로 등록합니다.
FROM qwen3:14b
PARAMETER num_gpu 24
ollama create qwen3-14b-gpu24 -f Modelfile
- 이 글에서 가장 좋았던 값은 24~26층입니다. 바탕화면·브라우저가 그래픽 메모리를 더 쓰고 있다면 24층부터 시작하세요.
- 그래픽 메모리가 모자라서 불러오기 자체가 실패하면 층 수를 2씩 줄이세요.
num_gpu는 Modelfile 문서의 설정 표에는 없지만, Ollama API 문서의 options 예시에 나오는 값이고 Modelfile의PARAMETER로도 동작했습니다(첫 측정 글).
측정 환경과 방법
- CPU: Intel Core i9-10900K, RAM: 32GB (3200MHz)
- 그래픽카드: NVIDIA GeForce GTX 1660 SUPER 6GB, 드라이버 591.86, Windows 11 Home
- Ollama 0.34.4, 모델
qwen3:14b(Q4_K_M,ollama ps기준 크기 10GB). Qwen3-14B는 40개 층으로 된 모델입니다. - 질문: "6GB 그래픽카드에서 양자화가 어떻게 대형 언어 모델을 실행할 수 있게 해 주는지 200단어 정도로 설명해 주세요." 생성 길이 128토큰, temperature 0, seed 고정, 생각 기능 끔(
think: false), 문맥 길이 4,096(Ollama가 자동으로 잡은 값,ollama ps기준). - 모델을 불러오는 첫 실행은 빼고 이어서 3회를 평균냈습니다. 설정마다 바꾼 것은
num_gpu하나입니다. - 측정 전에 그래픽 메모리 1,200MB 이하, CPU 25% 이하가 될 때까지 기다렸습니다(최대 20분).
- 1회차: 09-28 02:07~02:21, 2회차: 03:22~03:36.